O que significa "ajustar" uma gramática aos dados? A resposta tentadora é: fazer o que o modelo prevê parecer com o que a gente viu. Mas há uma forma mais limpa de dizer a mesma coisa — deixar o modelo o menos surpreso possível diante dos dados. E "surpresa" aqui não é figura de linguagem: é o quanto o dado é improvável segundo o modelo, o velho $-\log p$. Um modelo bem ajustado é aquele que acha os dados sem graça, esperados, pouco surpreendentes.
Some essa surpresa sobre todos os dados, cada um pesado por quantas vezes apareceu, e você tem a entropia cruzada — a surpresa média que o modelo sente diante dos dados. Ajustar é, nada mais, empurrar esse número para baixo.
Só que há um piso. Os dados têm a sua própria imprevisibilidade — a entropia deles. Ninguém consegue ficar menos surpreso do que isso; o melhor que dá para fazer é parar de se surpreender com aquilo que o modelo erra por conta própria. Essa surpresa extra, acima do piso, é a divergência de Kullback-Leibler — o tanto que o modelo está torto em relação aos dados. Diminua a KL e a entropia cruzada afunda até o piso.
Arraste os $\lambda$ e dobre a curva sobre o histograma, de olho na KL despencando; ou deixe a descida cuidar disso:
E é assim, no fundo, que uma gramática de máxima entropia aprende: um empurrãozinho nos pesos para reduzir a diferença entre o que ela prevê e o que ela viu, de novo e de novo, até a diferença ficar pequena. Minimizar a divergência e maximizar a verossimilhança são, aliás, o mesmo gesto (Goldwater & Johnson, 2003; Hayes & Wilson, 2008). Os pesos "certos" são só aqueles que tornam os candidatos observados o mais prováveis possível. Com o peso zerado, o modelo não sabe nada e reparte igual — longe das frequências que os dados mostram (0,54, 0,30, 0,16):
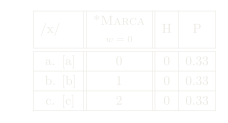
Ajustar o peso é justamente empurrar a probabilidade do modelo até bater com o observado:
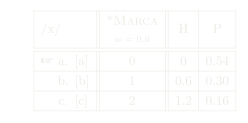
Vale conferir a conta em vez de confiar em mim. Para alguns valores de $\lambda$, repare como a KL cai e a entropia cruzada se aproxima do piso, sem nunca furá-lo:
import math
# Um histograma de dados e um modelo de máxima entropia. Ajustar = diminuir a KL
# entre os dois (o mesmo que maximizar a verossimilhança).
dados = [0.04, 0.09, 0.16, 0.21, 0.21, 0.16, 0.09, 0.04]
c = [((325 + 50 * i) - 300) / 400 for i in range(8)]     # centros normalizados
def modelo(l1, l2):
    w = [math.exp(-(l1 * ci + l2 * ci * ci)) for ci in c]
    Z = sum(w)
    return [wi / Z for wi in w]
def kl(p, q):        # em bits
    return sum(pi * math.log2(pi / qi) for pi, qi in zip(p, q) if pi > 0)

piso = -sum(pi * math.log2(pi) for pi in dados if pi > 0)
print(f"piso H(dados) = {piso:.3f} bits")
for (l1, l2) in [(0.0, 0.0), (-2.0, 2.0), (-4.3, 4.4)]:
    q = modelo(l1, l2)
    d = kl(dados, q)
    print(f"lambda=({l1:>4},{l2:>3})  KL={d:.4f}  entropia cruzada={piso + d:.3f} bits")
No fim, aprender não é acertar alguma verdade platônica. É uma negociação humilde: fique o menos surpreso que os dados permitirem, e aceite a surpresa que não dá para tirar. A KL só chega a zero se o seu modelo já for a verdade — o que, com dados de verdade, ele quase nunca é.
- Goldwater, S., & Johnson, M. (2003). Learning OT constraint rankings using a maximum entropy model. Preprint.
- Hayes, B., & Wilson, C. (2008). A Maximum Entropy Model of Phonotactics and Phonotactic Learning. Linguistic Inquiry.
Barroso, A. M. (2024). Ajustar uma gramática é diminuir a surpresa. alexandrebarroso.com. https://alexandrebarroso.com/notes/ajustar-e-diminuir-a-surpresa.html
@misc{barroso2024ajustarediminuirasurpresa,
  author       = {Alexandre Menezes Barroso},
  title        = {Ajustar uma gramática é diminuir a surpresa},
  year         = {2024},
  howpublished = {alexandrebarroso.com},
  url          = {https://alexandrebarroso.com/notes/ajustar-e-diminuir-a-surpresa.html},
  note         = {alexandrebarroso.com}
}