Surpresa tem uma definição limpa: o quanto um evento era improvável, $s=-\log_2 p$ — a informação que ele carrega (MacKay, 2005). Aplicada à leitura, a ideia é sedutora: se enxergarmos a compreensão como previsão, cada palavra pouco esperada custa um tanto a mais de esforço, e esse tanto vaza para o relógio, no tempo que levamos para lê-la (Griffiths et al., 2010).
Daí nasce a pergunta que todo mundo faz ao ver o gráfico: o tempo de leitura cresce em linha reta com a surpresa, ou a coisa entorta? A gente plota surpresa contra tempo e aperta os olhos, à espera de um veredito.
Só que o veredito depende da régua. Tempo de leitura não é um custo cognitivo puro; é um número que sai de um instrumento, e podemos deitá-lo num eixo de milissegundos ou no logaritmo desse eixo. A mesma nuvem endireita numa régua e entorta na outra — e nada nos dados mudou:
Pior (ou melhor): dá para mexer também do lado da surpresa, elevando-a a um expoente. Para cada régua existe um expoente que faz a nuvem parecer mais reta. O problema é que esse expoente não coincide entre as réguas: a dos milissegundos pede um valor, a do logaritmo pede outro. Quem escolhe o expoente "certo", no fundo, é a régua que você já tinha escolhido antes de olhar.
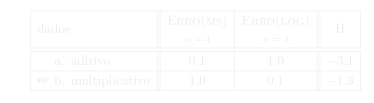
Se quisermos falar a língua dos tableaux, é fácil montar a encenação: dois relatos concorrem pelos mesmos dados — um aditivo, um multiplicativo —, cada um julgado por quão bem se ajusta em cada régua. Pese a régua dos milissegundos e vence o relato aditivo:
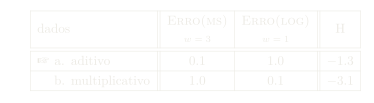
Pese a régua do logaritmo e, com exatamente os mesmos ajustes, o vencedor vira o multiplicativo:
Vale conferir a conta em vez de confiar no olho: um mesmo conjunto de pontos, o R² de uma reta em cada régua, e os dois expoentes que se recusam a coincidir:
import math
N = 40
S = [1 + 11 * i / (N - 1) for i in range(N)]
noise = [((i * 7919) % 101 - 50) / 50 * 10 for i in range(N)]   # mesmo ruído do gráfico
RT = [30 + 45 * S[i] + noise[i] for i in range(N)]

def R2(xs, ys):
    n = len(xs); mx = sum(xs) / n; my = sum(ys) / n
    sxx = sum((x - mx) ** 2 for x in xs)
    sxy = sum((xs[i] - mx) * (ys[i] - my) for i in range(n))
    syy = sum((y - my) ** 2 for y in ys)
    return sxy * sxy / (sxx * syy)

def melhor_k(ys):
    best = (0, -1); k = 0.3
    while k <= 2.0001:
        r = R2([s ** k for s in S], ys)
        if r > best[1]: best = (round(k, 2), r)
        k += 0.05
    return best

for nome, ys in [("ms", RT), ("log", [math.log(x) for x in RT])]:
    r1 = R2(S, ys)                       # reta em k=1
    bk, br = melhor_k(ys)
    print(f"régua {nome:3s}: R² em k=1 = {r1:.3f} ; melhor k = {bk} (R² = {br:.3f})")
No fim, a moral é quase um aviso de laboratório: a não-linearidade que você acha pode morar na vara de medir, não na mente. Antes de perguntar se uma curva entorta, vale perguntar com o que ela foi medida.
- MacKay, D. J. C. (2005). Information Theory, Inference, and Learning Algorithms. Cambridge University Press.
- Griffiths, T. L., Chater, N., Kemp, C., Perfors, A., & Tenenbaum, J. B. (2010). Probabilistic models of cognition: exploring representations and inductive biases. Trends in Cognitive Sciences.
Barroso, A. M. (2025). É linear? Pergunte à régua. alexandrebarroso.com. https://alexandrebarroso.com/notes/e-linear-pergunte-a-regua.html
@misc{barroso2025elinearperguntearegua,
  author       = {Alexandre Menezes Barroso},
  title        = {É linear? Pergunte à régua},
  year         = {2025},
  howpublished = {alexandrebarroso.com},
  url          = {https://alexandrebarroso.com/notes/e-linear-pergunte-a-regua.html},
  note         = {alexandrebarroso.com}
}