Antes de medir qualquer coisa, o que eu deveria acreditar sobre onde uma vogal vai cair? Imagine uma faixa de valores de primeiro formante e nenhuma informação nas mãos. A resposta honesta é uma linha reta: toda altura igualmente provável, porque ainda não sei nada sobre elas. Damos um nome a essa ignorância — entropia — e a linha reta é, de todas as distribuições, a que tem o máximo dela. Ela não se compromete com coisa alguma.
Agora suponha que eu meça uma única coisa. Não cada valor, mas uma média — digamos, o valor esperado de alguma restrição sobre os candidatos. De repente sei um fato. E a pergunta fica interessante: qual é a menor deformação que posso impor à linha reta para respeitar esse fato, sem contrabandear junto nada que eu não tenha medido?
A resposta é curiosamente arrumada:
$$p(F_1)=\frac{e^{-\lambda\,v(F_1)}}{Z}.$$
A exponencial é a forma mais lisa que ainda honra a média que medi; o $\lambda$ é exatamente o tanto de curvatura que aquele fato exige, nem mais nem menos; e o $Z$ ali embaixo é só a contabilidade que mantém tudo somando um. Arraste o $\lambda$ no painel abaixo e veja a linha reta ganhar corpo — e, ao lado, a entropia saindo do máximo assim que você acrescenta o primeiro compromisso.
Meça um segundo fato e ganhamos um segundo $\lambda$; a forma continua sendo a menos comprometida compatível com os dois. Cada restrição empurra a distribuição só até onde precisa, e o resto permanece tão indeciso quanto antes.
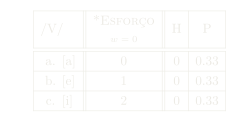
Sobre candidatos discretos isso é, ponto por ponto, uma gramática de máxima entropia: restrições ponderadas viram probabilidades. Foi mais ou menos assim, aliás, que a ideia entrou na fonologia (Goldwater & Johnson, 2003; Jäger, 2007). Com o peso zerado, a gramática "não sabe nada" e reparte tudo em partes iguais:
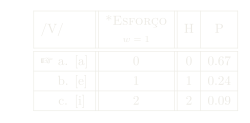
Ligue o peso e ela se compromete com quem viola menos — a probabilidade se concentra e a entropia desce:
Dá para conferir a aritmética em vez de confiar em mim. Para um punhado de valores de $\lambda$, repare como a entropia parte do máximo (a distribuição uniforme) e só cai à medida que ligamos a restrição:
import math
# Três candidatos com contagens de violação. Um único peso (lambda) entorta uma
# distribuição plana até uma comprometida; a entropia cai do seu máximo.
v = {"a": 0, "e": 1, "i": 2}
def maxent(lam):
    w = {k: math.exp(-lam * vi) for k, vi in v.items()}
    Z = sum(w.values())
    return {k: w[k] / Z for k in v}
def entropia(p):                     # em bits
    return -sum(pi * math.log2(pi) for pi in p.values() if pi > 0)

for lam in (0.0, 0.5, 1.0, 2.0):
    p = maxent(lam)
    linha = "  ".join(f"[{k}]={p[k]:.2f}" for k in v)
    print(f"lambda={lam:>3}  {linha}  H={entropia(p):.3f} bits")
Vale insistir no que isso não é. Não é uma afirmação de que o mundo é exponencial, nem de que as vogais "querem" seguir uma curva bonita. É mais uma disciplina de humildade: assuma o mínimo, dado aquilo que você de fato mediu. Cada $\lambda$ é o preço de um fato; a linha reta é o que sobra quando não se mediu nada. Máxima entropia, mínima suposição.
- Goldwater, S., & Johnson, M. (2003). Learning OT constraint rankings using a maximum entropy model. Preprint.
- Jäger, G. (2007). Maximum Entropy Models and Stochastic Optimality Theory. Preprint.
Barroso, A. M. (2024). Máxima entropia, mínima suposição. alexandrebarroso.com. https://alexandrebarroso.com/notes/maxima-entropia-minima-suposicao.html
@misc{barroso2024maximaentropiaminimasuposicao,
  author       = {Alexandre Menezes Barroso},
  title        = {Máxima entropia, mínima suposição},
  year         = {2024},
  howpublished = {alexandrebarroso.com},
  url          = {https://alexandrebarroso.com/notes/maxima-entropia-minima-suposicao.html},
  note         = {alexandrebarroso.com}
}