Um tableau é um objeto tão familiar que a gente esquece de olhar bem para ele. Candidatos numa coluna, restrições ponderadas nas outras, e no fim uma harmonia por candidato — a soma das violações vezes seus pesos, com o sinal trocado, para que "mais alto" queira dizer "melhor". Numa gramática estocástica, porém, não há um único vencedor: cada candidato ganha uma fatia de probabilidade.
De onde vem essa fatia? De uma conta que talvez você já tenha visto com outra roupa:
$$P(x)=\frac{e^{H(x)}}{\sum_y e^{H(y)}}.$$
Exponencie as harmonias, some, divida cada uma pela soma. Se isso te lembra alguma coisa, é porque é exatamente o softmax — a mesma função que, em aprendizado de máquina, transforma um punhado de escores num punhado de probabilidades. As harmonias fazem o papel dos escores; os pesos das restrições, o dos coeficientes; e a última etapa, a normalização exponencial, é o softmax. Um tableau ponderado é um modelinho log-linear, e o "vencedor" nada mais é do que o argmax.
Dá para ver a engrenagem girando. No painel abaixo, mexa nos pesos e observe as harmonias virarem probabilidades na hora:
E aqui está o botão que costuma faltar nos tableaux de sempre: a temperatura. Divida cada harmonia por um $T$ antes do softmax e você controla o quão decidida a gramática é. Com $T$ baixo, tudo colapsa no favorito — uma regra categórica. Com $T$ alto, as probabilidades se achatam rumo à uniforme — variação livre. Categórico e variável deixam de ser dois mundos e passam a ser dois ajustes de um mesmo botão.
Convém ancorar isso num tableau de verdade. Primeiro só as harmonias, como numa Gramática Harmônica:
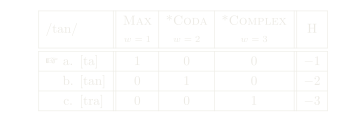
E o mesmo com uma coluna de probabilidade — as harmonias depois de passarem pelo softmax:
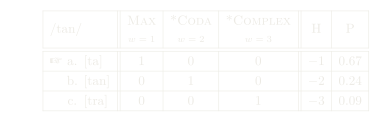
Para conferir a aritmética, aqui estão as mesmas harmonias viradas em probabilidades, e o que a temperatura faz com elas:
import math
# Harmonias de três candidatos (mais alto = melhor). O softmax as transforma em
# probabilidades; dividir por uma temperatura T deixa a gramática mais ou menos decidida.
H = {"ta": -1.0, "tan": -2.0, "tra": -3.0}
def softmax(H, T=1.0):
    e = {k: math.exp(h / T) for k, h in H.items()}
    Z = sum(e.values())
    return {k: e[k] / Z for k in H}

for T in (0.3, 1.0, 3.0):
    p = softmax(H, T)
    linha = "  ".join(f"[{k}]={p[k]:.2f}" for k in H)
    print(f"T={T:>3}  {linha}")
Nada disso é metáfora. A ponte entre gramáticas de restrições e os modelos estatísticos e conexionistas não é novidade (Prince & Smolensky, 1997; Pater, 2018), e a própria máquina de máxima entropia que a fonologia usa é, no fundo, um modelo log-linear (Goldwater & Johnson, 2003; Jäger, 2007). Ainda assim, é bonito ver um tableau e um softmax se revelarem o mesmo desenho. A gramática estocástica era um classificador o tempo todo; o vencedor é só o argmax; e a variação é o mesmo softmax numa temperatura um pouco mais quente.
- Prince, A., & Smolensky, P. (1997). Optimality: From Neural Networks to Universal Grammar. Science.
- Pater, J. (2018). Generative linguistics and neural networks at 60: foundation, friction, and fusion.
- Goldwater, S., & Johnson, M. (2003). Learning OT constraint rankings using a maximum entropy model. Preprint.
- Jäger, G. (2007). Maximum Entropy Models and Stochastic Optimality Theory. Preprint.
Barroso, A. M. (2024). Um tableau é um softmax. alexandrebarroso.com. https://alexandrebarroso.com/notes/um-tableau-e-um-softmax.html
@misc{barroso2024umtableaueumsoftmax,
  author       = {Alexandre Menezes Barroso},
  title        = {Um tableau é um softmax},
  year         = {2024},
  howpublished = {alexandrebarroso.com},
  url          = {https://alexandrebarroso.com/notes/um-tableau-e-um-softmax.html},
  note         = {alexandrebarroso.com}
}